

面试准备
1)Java:集合、多线程、内存、泛型、JNI 基础;
2)Kotlin:协程、Flow、空安全;
3)C++ 加分项准备:讲 JNI 调用、内存管理、指针、 JNI 调用 C++ 音视频库的经验
一、Java
1. 集合
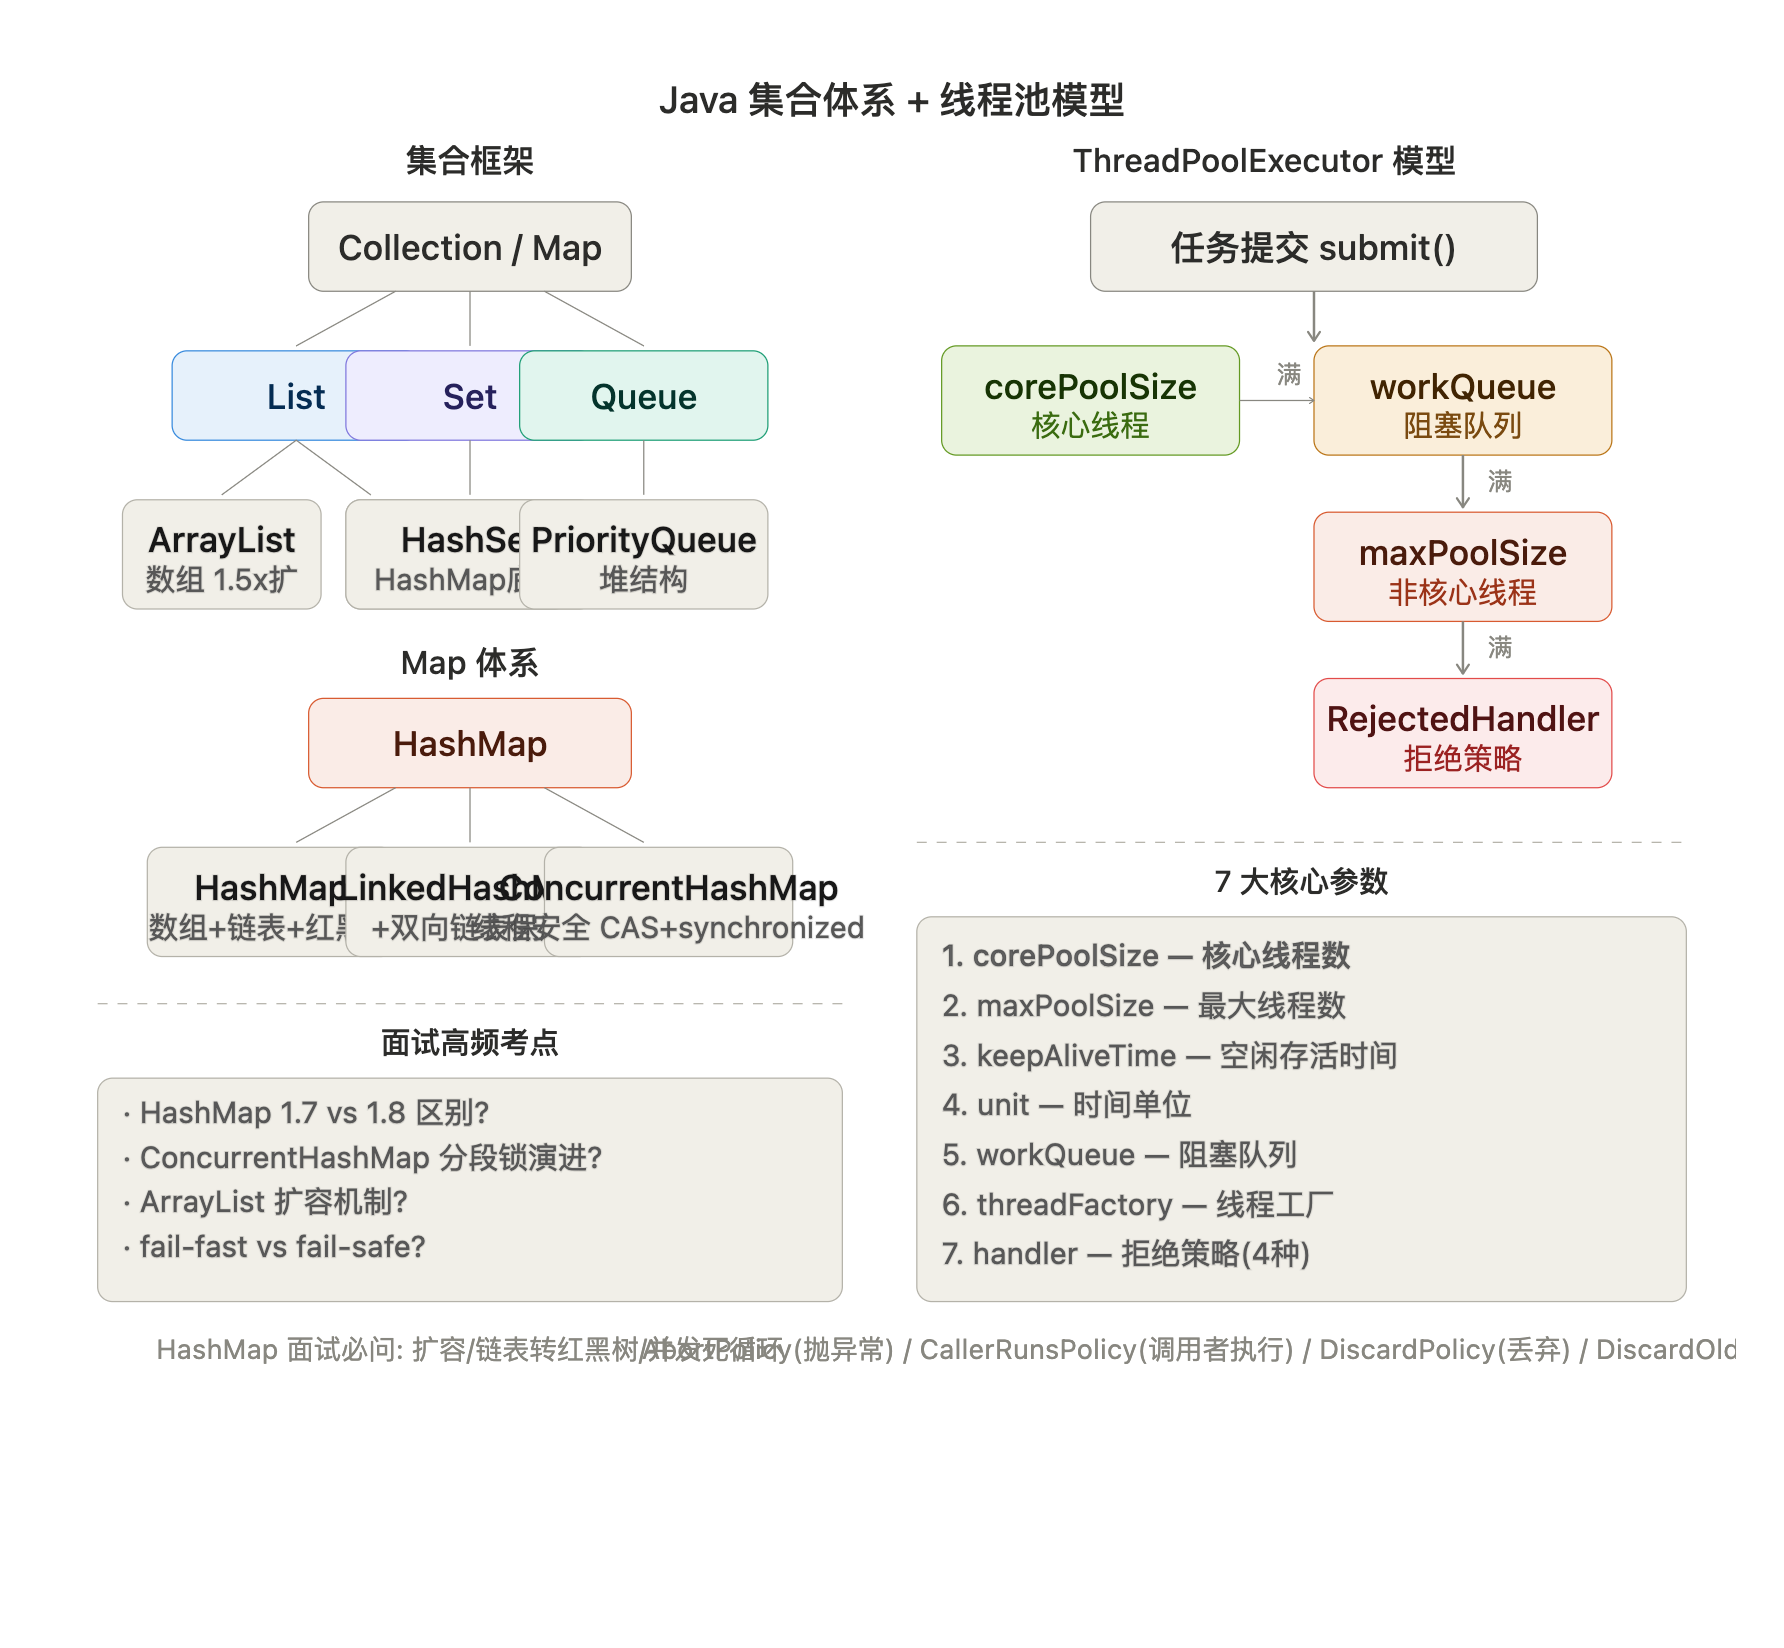
HashMap(面试必问,准备到源码级别)
1.7 vs 1.8 区别:1.7 是数组+链表,头插法(并发死循环);1.8 是数组+链表+红黑树,尾插法。链表长度 ≥8 且数组长度 ≥64 时转红黑树,≤6 时退化为链表
扩容机制:初始容量 16,负载因子 0.75,扩容翻倍(*2)。1.8 扩容时元素位置要么不变要么
原位置+旧容量,用hash & oldCap判断hash 计算:
(h = key.hashCode()) ^ (h >>> 16),高 16 位异或低 16 位,减少碰撞线程不安全:put 可能覆盖,扩容可能丢数据。并发场景用 ConcurrentHashMap
ConcurrentHashMap
1.7:Segment 分段锁,默认 16 段,每段独立加锁
1.8:去掉 Segment,用 CAS + synchronized 锁单个桶节点。put 时先 CAS 写入空桶,非空则 synchronized 锁链表头节点。size 用 CounterCell 并发计数
ArrayList
初始容量 10,扩容 1.5 倍(
oldCapacity + oldCapacity >> 1)System.arraycopy做数组拷贝fail-fast:迭代时 modCount 检查,并发修改抛
ConcurrentModificationException
2. 多线程
线程池(7 大参数 + 工作流程 + 4 种拒绝策略,必问)
工作流程:核心线程 → 队列 → 非核心线程 → 拒绝策略
4 种拒绝策略:
AbortPolicy:抛 RejectedExecutionException(默认)CallerRunsPolicy:调用者线程执行(降级常用)DiscardPolicy:静默丢弃DiscardOldestPolicy:丢弃队列最老任务
加分:Executors 提供的四种线程池为什么不推荐用?因为 newFixedThreadPool 和 newSingleThreadExecutor 队列是 LinkedBlockingQueue(无界),可能 OOM;newCachedThreadPool 最大线程 Integer.MAX_VALUE,也可能 OOM。生产环境必须用 ThreadPoolExecutor 手动构造。
synchronized vs ReentrantLock
volatile
保证可见性(MESI 缓存一致性协议 + 内存屏障)
禁止指令重排序(Store-Store / Load-Load 屏障)
不保证原子性(
i++仍不安全)典型应用:DCL 单例的
volatile修饰
ThreadLocal
每个线程有独立
ThreadLocalMap,key 是 ThreadLocal 弱引用,value 是强引用内存泄漏:value 不会被回收(key 回收后 value 仍在),需要手动
remove()加分:InheritableThreadLocal 可以父子线程传递,但线程池场景要用
TransmittableThreadLocal
3. 内存模型
JVM 内存区域
堆:对象实例 + 数组,GC 主战场。分新生代(Eden + 2 Survivor,8:1:1)和老年代
方法区/元空间:类信息、常量池、静态变量。1.8 从永久代改为本地内存元空间
虚拟机栈:方法栈帧(局部变量表、操作数栈、动态链接)
本地方法栈:native 方法
程序计数器:当前线程执行位置
GC 算法
判断存活:可达性分析,GC Roots(栈引用、静态变量、JNI 引用)
回收算法:标记-清除(碎片)、复制(浪费空间)、标记-整理
分代回收:新生代用复制算法,老年代用标记-整理
GC 收集器:CMS(低延迟,标记-清除)、G1(Region 化,可预测停顿)、ZGC(着色指针,<10ms)
加分:G1 将堆分为 2048 个 Region,每个 1-32MB,混合回收(新生代 + 老年代部分 Region)。-XX:MaxGCPauseMillis 设定目标停顿时间。
4. 泛型
类型擦除:编译后泛型类型被擦除为 Object 或上界,运行时无泛型信息。
List<String>和List<Integer>运行时都是List通配符:
<? extends T>上界只读(生产者),<? super T>下界只写(消费者)—— PECS 原则类型安全:编译期检查,运行时
ClassCastException提前到编译期桥接方法:泛型擦除后为了保持多态,编译器生成桥接方法
5. JNI 基础
数据类型映射:
int→jint,byte[]→jbyteArray,Object→jobject,String→jstring静态 vs 实例方法:静态方法第二个参数是
jclass,实例方法是jobject签名规则:
I= int,[B= byte[],Ljava/lang/String;= String,(I[BI)I= 参数(int, byte[], int) 返回 intJNIEnv:线程相关,每个线程有自己的 JNIEnv,不能跨线程传递
二、Kotlin
1. 协程
协程 vs 线程
协程是用户态轻量级线程,挂起不阻塞线程,由 Kotlin 运行时调度
一个线程可以跑多个协程,协程切换成本远低于线程切换
协程核心是挂起函数(suspend),编译后生成 CPS(Continuation Passing Style)状态机
核心组件
CoroutineScope:管理协程生命周期,取消时自动取消子协程CoroutineDispatcher:Dispatchers.IO(线程池)、Dispatchers.Main(主线程)、Dispatchers.Default(CPU 密集)Job:协程句柄,可 cancel/joinDeferred<T>:带返回值的 Job,await()获取结果
launch vs async
launch:启动协程不返回结果,返回 Job。用于 fire-and-forgetasync:启动协程返回 Deferred<T>,await()拿结果。用于并发请求
结构化并发
父协程取消 → 所有子协程自动取消
父协程等待所有子协程完成才完成
异常会向上传播,除非用
SupervisorJob隔离
加分:协程本质是编译器变换 + 线程池调度。suspend 函数编译后会多一个 Continuation 参数,通过状态机实现挂起恢复。挂起时保存局部变量到 Continuation,恢复时从 Continuation 恢复。
2. Flow
冷流:类似 Sequence,每次 collect 才开始发射数据。不消费不生产
背压:
buffer()(缓冲)、conflate()(只保留最新)、collectLatest()(取消上一个慢的)异常处理:
catch { }操作符(只能 catch 上游异常)完成处理:
onCompletion { },无论正常结束还是取消都会调用热流 StateFlow/SharedFlow:StateFlow 替代 LiveData,必须有初始值,conflation 去重;SharedFlow 支持多播,可配置 replay 缓存
面试加分:
kotlin
// Flow 是冷流,不 collect 不执行
val flow = flow { emit(1) }  // 定义时不执行
flow.collect { println(it) } // collect 时才执行

// StateFlow vs SharedFlow
// StateFlow = SharedFlow with replay=1, conflate=true
// StateFlow 总是有值,适合 UI 状态
// SharedFlow 更灵活,适合事件总线
3. 空安全
编译期检查:
String不可空,String?可空。编译器在调用点强制检查安全调用:
?.(空则不执行)、?:(elvis,空则默认值)、!!(非空断言,空则 NPE)let 配合:
nullable?.let { ... }替代 if-null 检查平台类型:Java 互操作时返回类型是平台类型(
String!),需要手动确认可空性
三、C++ 加分项
1. 指针与内存管理
智能指针(现代 C++ 核心)
unique_ptr:独占所有权,不可拷贝可 move,开销为零shared_ptr:共享所有权,引用计数,线程安全的计数操作但对象访问不安全weak_ptr:弱引用,不增加引用计数,解决shared_ptr循环引用
加分:
shared_ptr控制块是堆分配的,用make_shared可以将对象和控制块分配在同一块内存,减少一次内存分配shared_ptr的引用计数是原子操作(性能有开销),不要在热路径大量使用RAII:Resource Acquisition Is Initialization,资源获取即初始化。构造函数获取资源,析构函数释放资源,是 C++ 内存管理的核心思想
裸指针的坑
野指针:delete 后没有置 null,继续访问
悬空指针:指向的内存已被释放
内存泄漏:new 了没有 delete
重复释放:同一块内存 delete 两次 → 堆损坏
2. JNI 调用要点
静态注册 vs 动态注册
静态注册:
Java_com_pkg_Class_method命名规则,JNI 自动查找。简单但每次调用有名字查找开销动态注册:
JNI_OnLoad中用RegisterNatives注册,性能好,混淆友好。生产环境推荐
引用类型
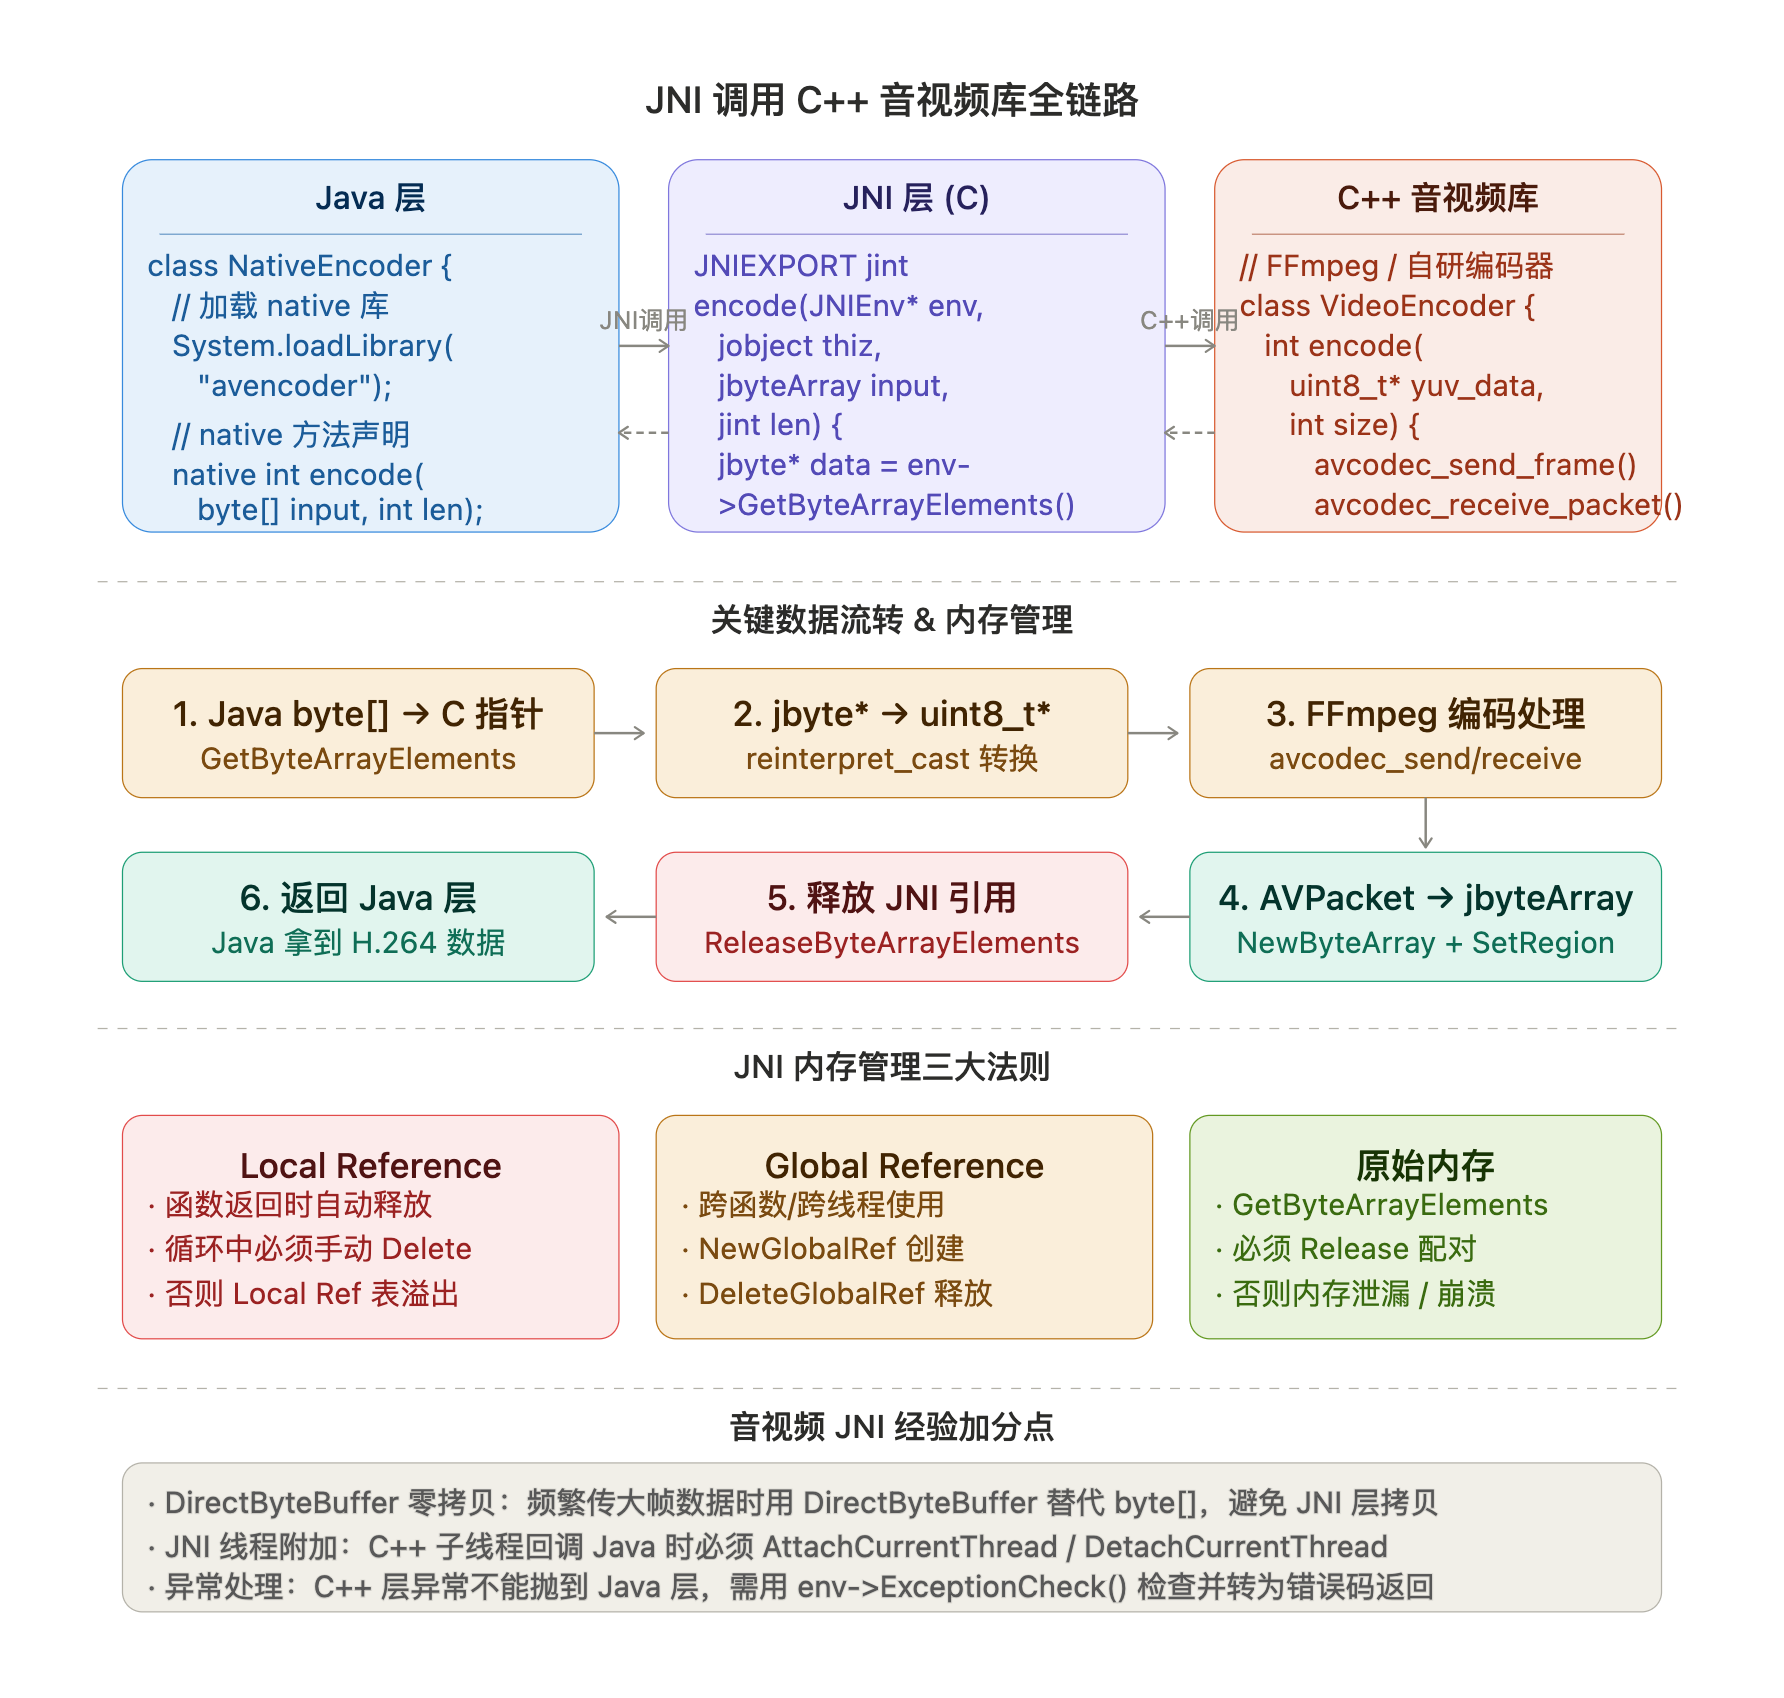
Local Reference:函数内自动创建,函数返回时自动释放。但在循环中创建不释放会撑爆 Local Ref 表(默认 512 个),必须手动
DeleteLocalRefGlobal Reference:跨函数/跨线程使用,
NewGlobalRef创建,DeleteGlobalRef释放。注意泄漏Weak Global Reference:不阻止 GC 回收,使用前要
IsSameObject检查是否存活
3. JNI 调用 C++ 音视频库经验(重点加分)
典型架构:
plaintext
Java (Kotlin) 推流 SDK
    → JNI 层 (C++ wrapper)
        → FFmpeg libavcodec / libavformat (编码封装)
        → 自研 C++ 编码器 (MediaCodec 降级方案)
    → 回调 Java 层 (编码后的 H.264 NAL)
关键经验点:
DirectByteBuffer 零拷贝
频繁传递大帧数据(如 1080p YUV ≈ 3MB),用
byte[]每次都要 JNI 拷贝改用
DirectByteBuffer,C++ 层GetDirectBufferAddress直接拿指针,零拷贝Java 侧分配:
ByteBuffer.allocateDirect(size),C++ 侧env->GetDirectBufferAddress(buf)
线程回调 Java
FFmpeg 编码是异步的,编码完成后在 C++ 子线程回调
子线程没有 JNIEnv,必须
JavaVM->AttachCurrentThread(&env, nullptr)获取回调完后
DetachCurrentThread,否则线程退出时崩溃最佳实践:用
pthread_key_t线程局部存储管理 JNIEnv 生命周期
异常边界处理
C++ 异常不能跨 JNI 传播到 Java 层(直接 crash)
JNI 函数必须
try-catch包裹所有 C++ 调用catch 后用
env->ThrowNew(env->FindClass("java/lang/RuntimeException"), msg)抛 Java 异常或者返回错误码,Java 层根据错误码处理
编码器生命周期管理
JNI_OnLoad中初始化 JavaVM 指针和 Java 方法 ID(缓存,避免每次查找)Java 层 init 时创建 C++ Encoder 对象,返回
jlonghandle 给 Java 层持有Java 层 release 时通过 handle 找到 C++ 对象 delete,然后置 0
用
GlobalRef持有 Java 回调对象,防止 GC 回收
cpp
// 典型 handle 模式
static jlong nativeInit(JNIEnv* env, jobject thiz) {
    auto* encoder = new VideoEncoder();
    return reinterpret_cast<jlong>(encoder);
}

static jint nativeEncode(JNIEnv* env, jobject thiz, jlong handle, jobject input) {
    auto* encoder = reinterpret_cast<VideoEncoder*>(handle);
    uint8_t* data = (uint8_t*)env->GetDirectBufferAddress(input);
    return encoder->encode(data, env->GetDirectBufferCapacity(input));
}

static void nativeRelease(JNIEnv* env, jobject thiz, jlong handle) {
    auto* encoder = reinterpret_cast<VideoEncoder*>(handle);
    delete encoder;
}
面试话术建议
自我介绍时:重点突出"Android 音视频方向,熟悉 MediaCodec 硬编 + RTMP 推流,有 JNI 调 C++ 音视频库经验"。
被问到 JNI 时:主动说"我在项目中用 JNI 封装了 FFmpeg 编码层,Java 层通过 DirectByteBuffer 传 YUV 数据实现零拷贝,C++ 编码完成后在子线程回调 Java,用 AttachCurrentThread 管理 JNIEnv 生命周期"。
被问到协程时:可以结合直播场景说"推流 SDK 用协程管理采集→编码→推流的 pipeline,用 Flow 做帧数据的流式处理,背压用 buffer + conflate 控制"。
被问到性能优化时:引到前面的弱网策略,展示工程深度。