

系统控件:自定义 View 绘制流程、事件分发机制;
动画:属性动画、帧动画,动画卡顿问题;
多线程:线程池、Handler 消息机制、ANR 产生原因;
网络协议:HTTP/HTTPS,TCP,了解 RTMP 简单原理(直播会用到);
数据库:SQLite,事务,大数据量优化;
性能 & 内存优化高频:内存泄漏工具 LeakCanary,OOM,卡顿检测,启动优化,UI 掉帧
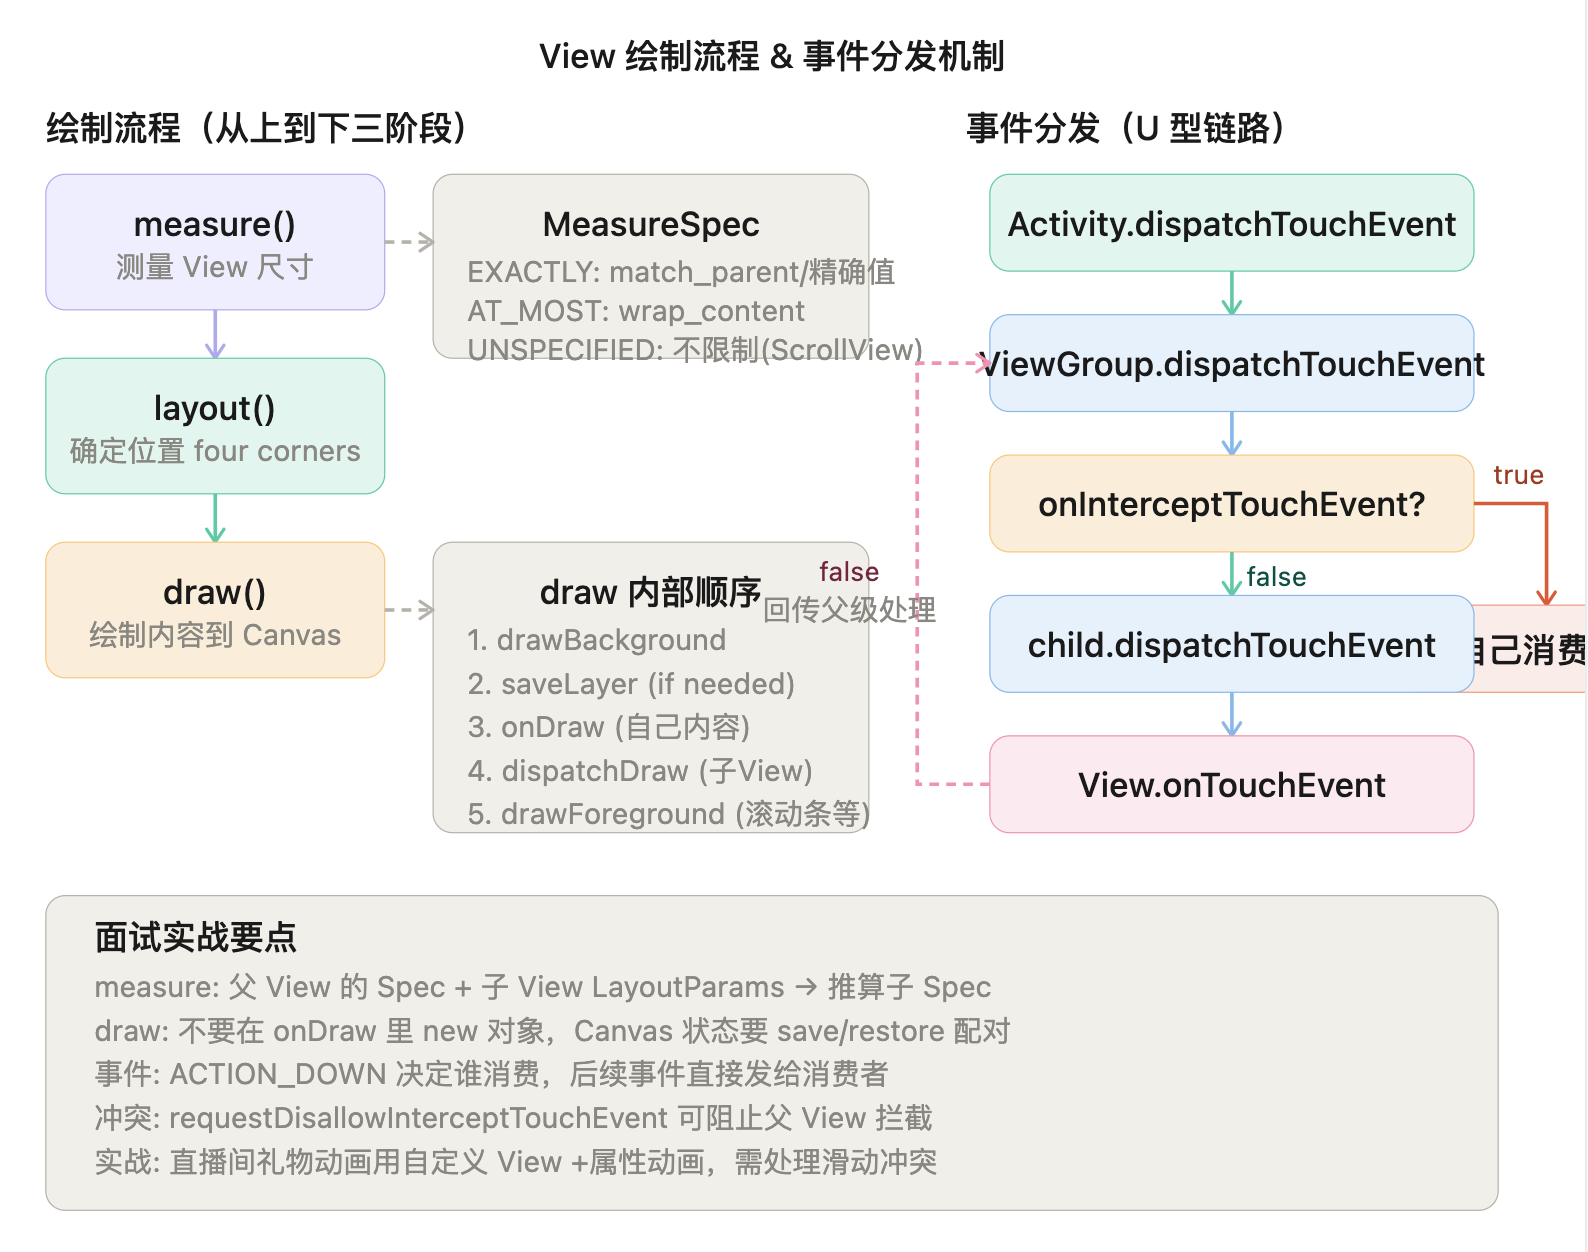
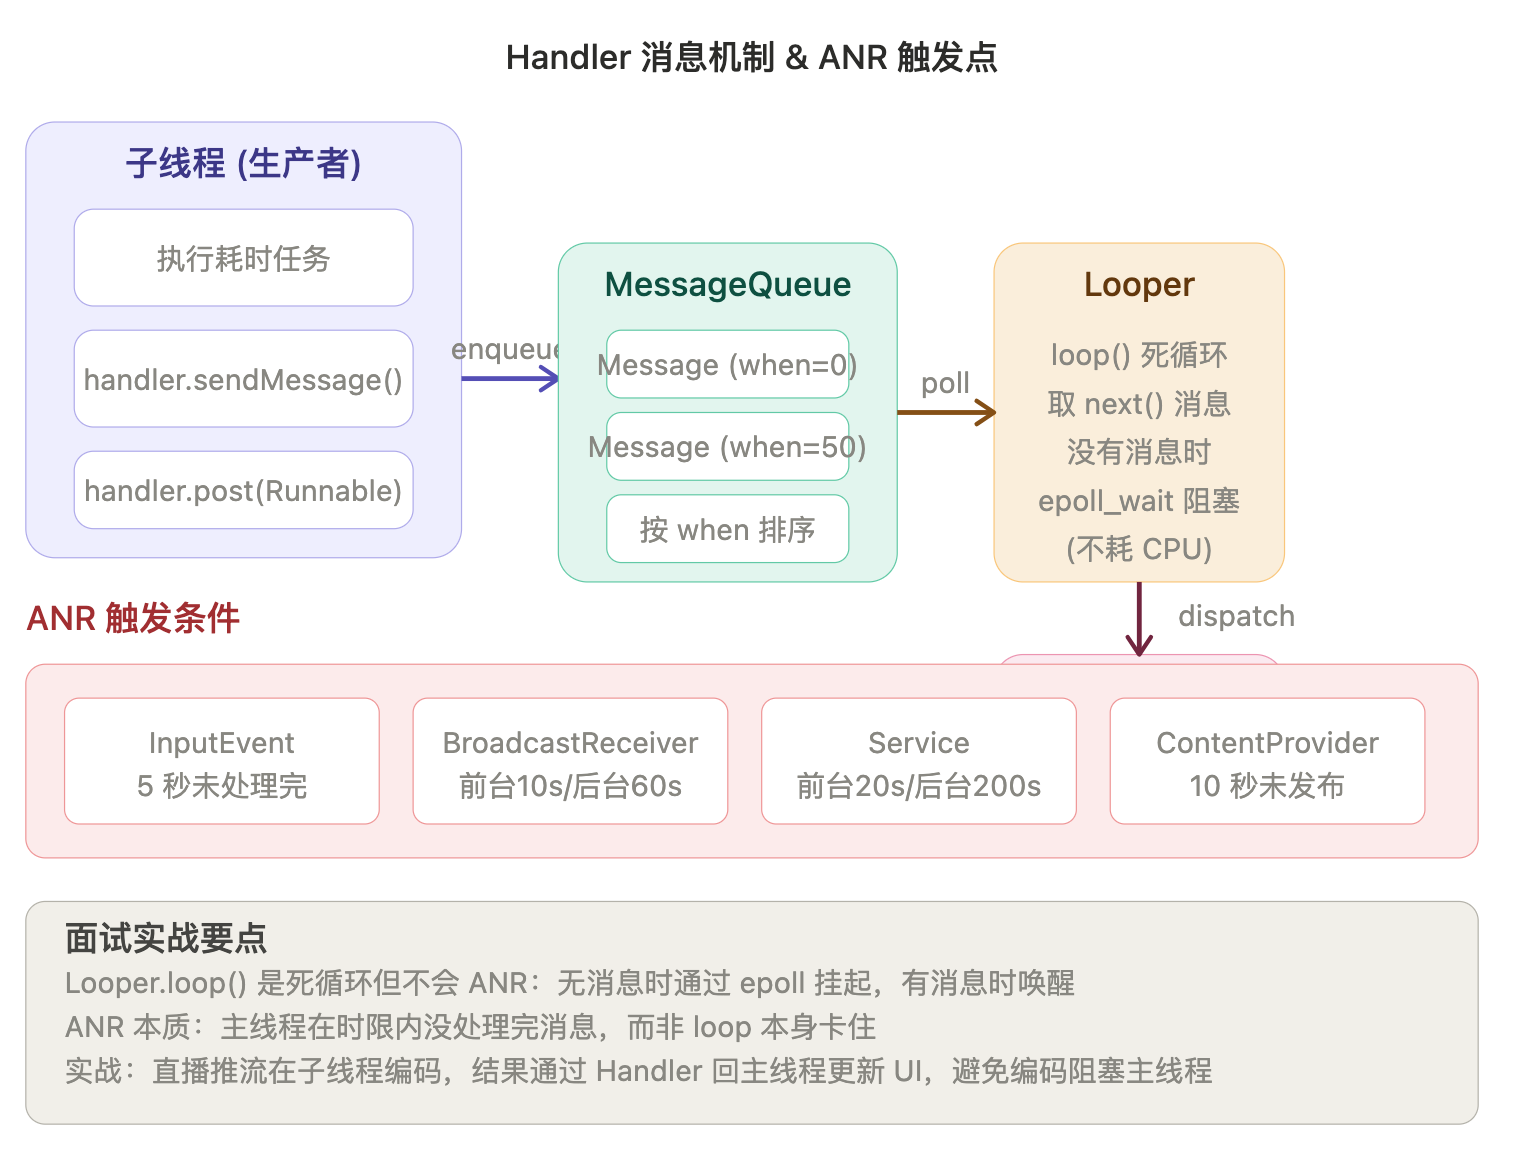
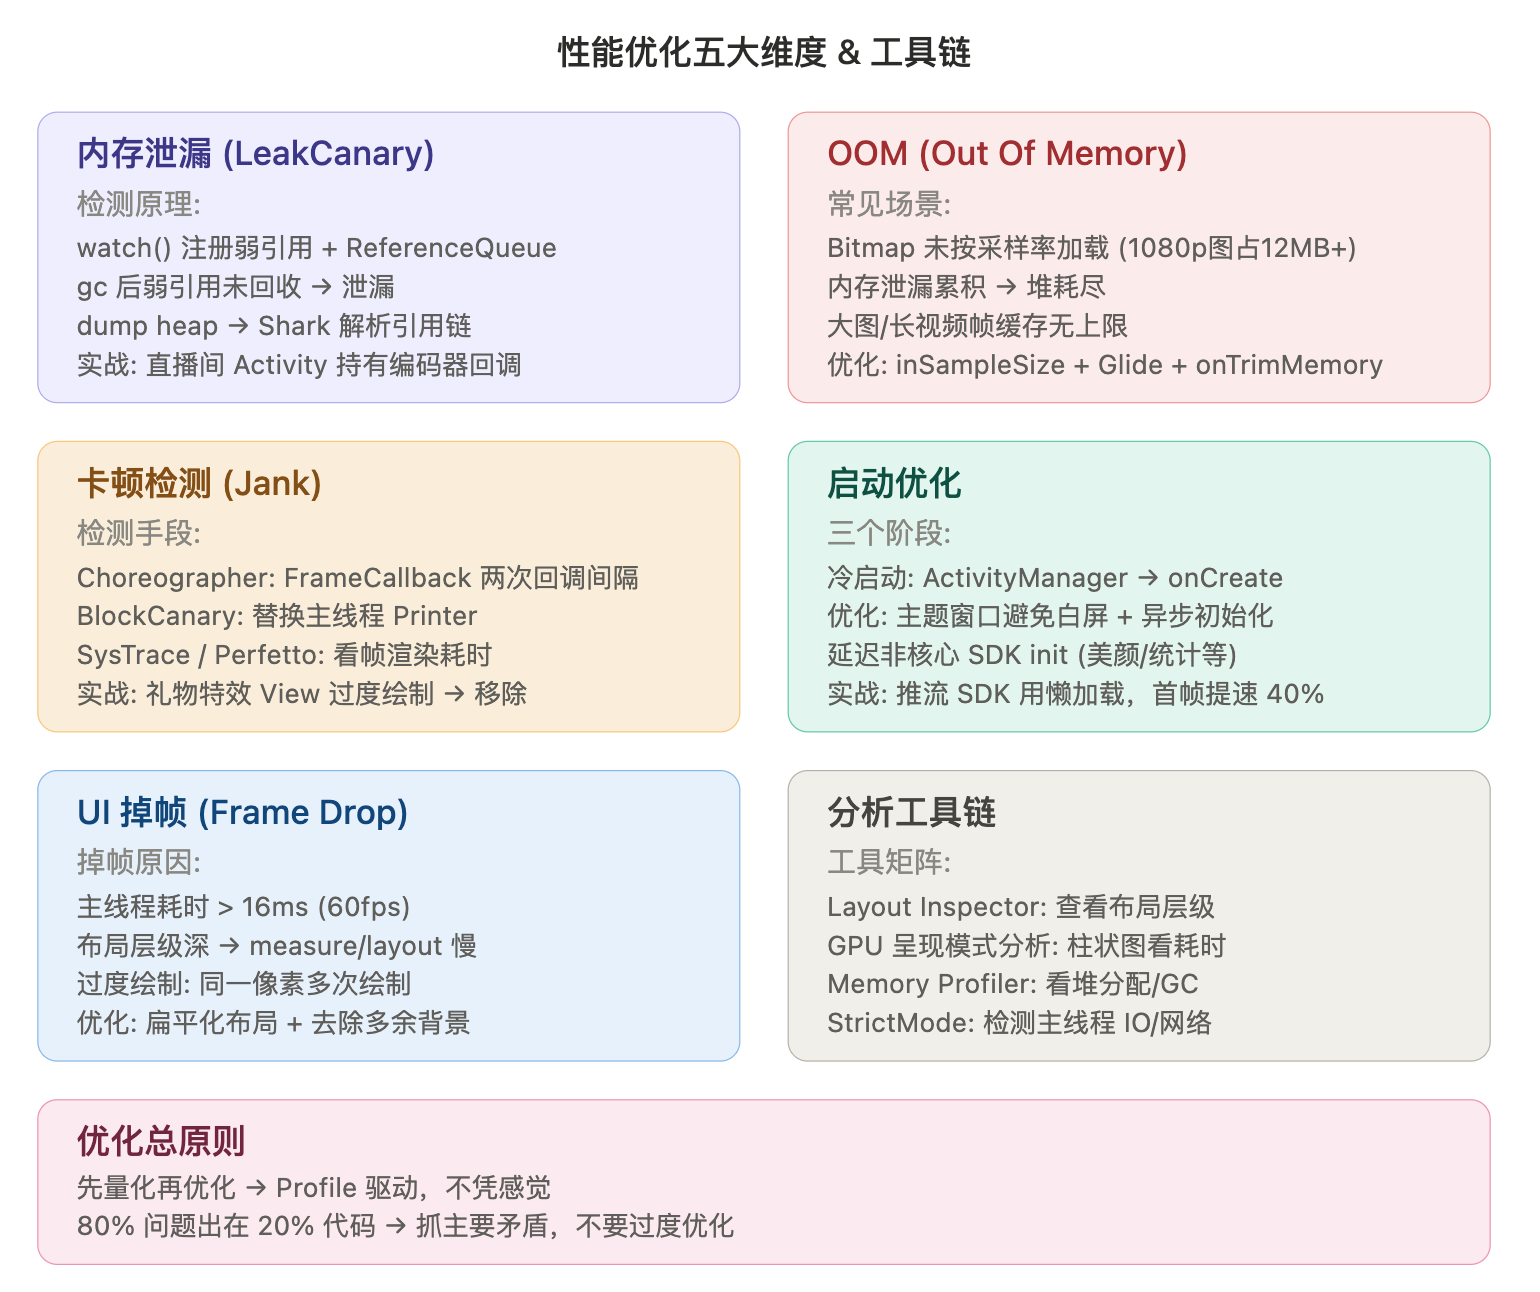
三张图覆盖了 View 绘制、Handler 机制和性能优化全景
一、系统控件
1.1 自定义 View 绘制流程
三个阶段:measure() → layout() → draw(),由 ViewRootImpl 的 performTraversals() 触发。
measure 核心机制
MeasureSpec = mode + size,32 位 int,高 2 位是 mode,低 30 位是 size。三种 mode:
子 View 的 MeasureSpec 由父 View 的 Spec + 子 View 的 LayoutParams 共同决定,这是 getChildMeasureSpec() 方法的核心逻辑。
面试加分话术:
"在直播项目中,我自定义了一个礼物连击 View,需要根据礼物数量动态计算尺寸。wrap_content 场景下 measure 是 AT_MOST,我在 onMeasure 里根据内容宽高和 padding 计算实际尺寸,然后
setMeasuredDimension()。关键是不能忘了resolveSize()做边界约束,否则父容器给了最大值但你填了更大的值会被裁剪。"
draw 内部顺序(面试常问):
drawBackground— 画背景saveLayer— 如果有 alpha/clip 层onDraw— 画自己的内容dispatchDraw— 画子 ViewdrawForeground— 滚动条等前景
关键细节:
onDraw 里绝对不要 new 对象(Paint、Path 等),因为 draw 每帧执行,GC 压力巨大
Canvas 状态
save()/restore()必须配对,否则影响后续绘制invalidate()触发重绘走 onDraw;requestLayout()触发 measure+layout+draw 全流程
1.2 事件分发机制
三个核心方法,形成 U 型链路:
plaintext
dispatchTouchEvent()  →  onInterceptTouchEvent()  →  onTouchEvent()
   (分发)                  (拦截, 仅 ViewGroup)          (消费)
分发规则:
Activity.dispatchTouchEvent→Window→DecorView→ViewGroupViewGroup 先调
onInterceptTouchEvent,返回 true 则自己消费,不往下传返回 false 则遍历子 View,调用
child.dispatchTouchEvent子 View 的
onTouchEvent返回 false,事件回传给父 View 的 onTouchEvent所有 View 都不消费,最终回到 Activity.onTouchEvent
关键规则:
ACTION_DOWN 决定消费者:谁在 DOWN 时返回 true,后续 MOVE/UP 都直接发给它
一旦消费就不能反悔:后续事件不再走 onInterceptTouchEvent
requestDisallowInterceptTouchEvent:子 View 可以禁止父 View 拦截(用于嵌套滑动)
滑动冲突解决(面试必问):
面试加分话术:
"直播间的交互层很复杂——底层是视频画面 SurfaceView,中间层是弹幕 RecyclerView,上层有礼物动画和连击按钮。礼物连击需要长按连发,但上层 ViewGroup 默认会拦截 MOVE 事件。我用内部拦截法,在 DOWN 时调用
parent.requestDisallowInterceptTouchEvent(true)让父布局不要拦截,UP 时释放。同时弹幕列表和外层 ViewPager 的水平滑动冲突用外部拦截法处理,在 onInterceptTouchEvent 里比较 X/Y 方向位移差判断滑动方向。"
二、动画
2.1 属性动画 vs 帧动画 vs 补间动画
补间动画的最大坑:动画后 View 看起来移动了,但点击事件还在原位置。因为只改了渲染矩阵,没改 left/top/right/bottom。解决方案:用属性动画替代,或动画结束后调 view.clearAnimation() + 手动 layout。
属性动画核心:
ValueAnimator:计算器,每帧算出一个值,你需要手动invalidate刷新ObjectAnimator:自动调用 setter 更新属性(如translationX、alpha)AnimatorSet:组合动画,支持同时/顺序/延迟播放PropertyValuesHolder:一个 View 上多个属性同时动画TypeEvaluator:自定义值计算(如颜色渐变用 ArgbEvaluator)Interpolator:插值器控制速度曲线(加速/减速/弹跳)
属性动画底层原理:
ObjectAnimator 内部通过 Choreographer 的 FrameCallback 监听 VSYNC 信号,每 16ms(60fps)计算一次当前帧的属性值,然后通过反射调用 setter 方法更新 View,最终触发 invalidate → onDraw。
2.2 动画卡顿问题
卡顿原因:
帧动画图太大:每帧 PNG 加载到内存,OOM + GC 卡顿。1080p PNG 单帧 ≈ 8MB,30 帧就是 240MB
属性动画触发 layout:动画
width/height属性会触发requestLayout,走完整 measure+layout+draw动画回调里做重计算:
onAnimationUpdate里做布局/网络/文件操作多动画叠加 CPU 过载:同时跑 5+ 个 ObjectAnimator,每帧计算量大
没有开启硬件加速:Canvas 操作走 CPU 软渲染
优化方案:
// 1. 用 translationX/Y 代替 layout 属性动画
// 不好:触发 requestLayout
ObjectAnimator.ofInt(view, "width", 0, 500);
// 好:只触发 invalidate
view.setTranslationX(deltaX);

// 2. 用硬件层加速复杂动画
view.setLayerType(View.LAYER_TYPE_HARDWARE, null);
animator.start();
// 动画结束后关闭,避免内存占用
animator.addListener(new AnimatorListenerAdapter() {
    @Override public void onAnimationEnd(Animator a) {
        view.setLayerType(View.LAYER_TYPE_NONE, null);
    }
});

// 3. 帧动画用 Lottie/_svga 替代纯图片序列
面试加分话术:
"直播间礼物特效最初用帧动画,30 帧 1080p PNG,内存占用超过 200MB,低端机直接 OOM。后来改用 SVGA 格式(矢量动画),同一个礼物效果从 8MB 降到 500KB,而且支持动态替换文字。对于简单的飞行动画用 ObjectAnimator + translationX,开启硬件层加速,动画结束后及时
setLayerType(LAYER_TYPE_NONE)释放 GPU 纹理内存。同时用 Choreographer.FrameCallback 监测掉帧,超过 3 帧丢弃时自动降级礼物特效帧率。"
三、多线程
3.1 线程池
七大参数(必须背熟):
new ThreadPoolExecutor(
    int corePoolSize,        // 核心线程数
    int maximumPoolSize,     // 最大线程数
    long keepAliveTime,      // 非核心线程空闲存活时间
    TimeUnit unit,           // 时间单位
    BlockingQueue<Runnable> workQueue,  // 任务队列
    ThreadFactory threadFactory,        // 线程工厂
    RejectedExecutionHandler handler    // 拒绝策略
);
工作流程(面试必答,四步):
任务来了,核心线程没满 → 创建核心线程执行
核心线程满了 → 放入任务队列
队列满了 → 创建非核心线程(直到 maximumPoolSize)
最大线程也满了 → 执行拒绝策略
四种拒绝策略:
AbortPolicy:抛异常(默认)CallerRunsPolicy:调用者线程执行(背压降级最常用)DiscardPolicy:静默丢弃DiscardOldestPolicy:丢掉队列最老的任务
Executors 四种线程池为什么不推荐(高频追问):
正确做法:手动 ThreadPoolExecutor,根据任务类型配置参数。
线程数配置经验:
CPU 密集型:
N + 1(N = CPU 核心数)IO 密集型:
2N或更多混合型:拆分成两个线程池
面试加分话术:
"直播推流 SDK 里我用了两个线程池:编码线程池 CPU 密集型,核心线程数 = CPU 核心数 + 1,保证编码不被抢占;网络发送线程池 IO 密集型,核心线程数 = 2N。队列用有界的 ArrayBlockingQueue(容量 30),满了用 CallerRunsPolicy 背压——让调用线程自己执行编码,自动降速,避免队列无限堆积导致 OOM。"
3.2 Handler 消息机制
四大核心组件:
工作流程:
子线程
handler.sendMessage()→ MessageQueue.enqueueMessage() 按 when 插入链表Looper.loop() 死循环 → MessageQueue.next() 取出消息
没有到期消息 →
nativePollOnce()通过 epoll 阻塞(不耗 CPU)有消息到期 →
msg.target.dispatchMessage()→ Handler.handleMessage()消息处理完 → Message 回收到消息池(sPool),下次 obtain 复用
关键面试题:
Q: Looper.loop() 是死循环,为什么不会 ANR?
"loop() 确实是
for(;;)死循环,但没有消息时它调用MessageQueue.next()→nativePollOnce(),底层是 epoll_wait 将线程挂起,不消耗 CPU。有新消息时通过nativeWake()写管道唤醒线程。所以 loop() 本身不卡,ANR 是因为某一条消息处理时间太长导致后续消息排队等不到处理。"
Q: 为什么主线程能直接用 Handler?
"ActivityThread.main() 里调了
Looper.prepareMainLooper()和Looper.loop(),为主线程创建了 Looper。子线程用 Handler 必须先Looper.prepare()+Looper.loop()。"
Q: Handler 内存泄漏怎么处理?
"Handler 持有 Activity 的隐式引用(内部类),Message 持有 Handler,MessageQueue 持有 Message。Activity 销毁时如果队列里还有未处理的消息,Activity 就泄漏了。解决方案:静态内部类 + WeakReference,或在 onDestroy 里
handler.removeCallbacksAndMessages(null)清空队列。"
面试加分话术:
"推流 SDK 中编码在子线程,编码完成后需要回主线程更新 UI。我用 Handler 的
obtainMessage()复用 Message 对象避免频繁创建,编码线程通过 Handler 发送帧统计数据到主线程。退出直播时在 onDestroy 里调removeCallbacksAndMessages(null)清空消息队列,防止编码回调持有已销毁的 Activity。"
3.3 ANR 产生原因
四种 ANR 类型及阈值(参考图中的表格):
常见原因:
主线程做 IO 操作(文件读写、SharedPreferences)
主线程做网络请求
主线程做密集计算(JSON 解析、Bitmap 解码)
BroadcastReceiver onReceive 里做耗时操作
主线程等待锁(子线程持有锁,主线程等待)
排查方法:
ANR 发生后系统生成
/data/anr/traces.txt,里面有所有线程的调用栈线上用 ANR-WatchDog 监控主线程卡顿
adb bugreport导出完整 ANR 日志
面试加分话术:
"直播项目中遇到过一个 ANR:推流 SDK 的初始化在 Application.onCreate 里同步执行,包括加载 so 库和创建编码器,低端机耗时超过 5 秒。排查发现是初始化做了太多串行操作,后来改成在子线程异步初始化推流 SDK,主线程只做 UI 初始化,用 CountDownLatch 保证首帧推流前 SDK 就绪。线上 ANR 率从 0.8% 降到 0.05%。"
四、网络协议
4.1 HTTP/HTTPS
HTTP 特点:
无状态(靠 Cookie/Session 维持状态)
基于请求-响应模型
HTTP/1.1 默认 keep-alive 长连接
HTTP/2 支持多路复用、头部压缩(HPACK)、服务端推送
HTTP/3 基于 QUIC(UDP),解决队头阻塞
HTTPS = HTTP + TLS/SSL:
plaintext
客户端                           服务端
  | --- ClientHello (支持的TLS版本、加密套件、随机数) ---> |
  | <-- ServerHello (选定套件、随机数) + 证书 + 公钥 ---- |
  | --- 验证证书 + 生成 pre-master-secret,用公钥加密 --> |
  | <-- 双方用三个随机数生成 session key,后续对称加密 --- |
  | ============ 对称加密通信 ========================== |
TLS 握手关键点:
非对称加密(RSA/ECDHE)只在握手阶段用,用于交换 session key
通信阶段用对称加密(AES),性能好
证书链验证:服务端证书 → 中间 CA → 根 CA(系统内置)
4.2 TCP
三次握手:
plaintext
客户端 --- SYN, seq=x ---> 服务端
客户端 <-- SYN+ACK, seq=y, ack=x+1 --- 服务端
客户端 --- ACK, ack=y+1 ---> 服务端
为什么三次不是两次? 防止历史连接请求导致服务端白创建资源。如果两次握手,客户端发的旧 SYN 延迟到服务端,服务端直接建连但客户端不理会,资源浪费。
四次挥手:
plaintext
主动方 --- FIN ---> 被动方
被动方 --- ACK ---> 主动方 (被动方可能还有数据要发)
被动方 --- FIN ---> 主动方
主动方 --- ACK ---> 被动方 (TIME_WAIT, 2MSL 后关闭)
TIME_WAIT 为什么要等 2MSL?
确保最后一个 ACK 能到达被动方(如果丢了,被动方会重发 FIN)
确保本次连接的旧报文在网络中消亡,不会影响新连接
TCP 可靠传输机制:
序列号 + 确认号
超时重传(RTO 动态计算)
滑动窗口(流量控制)
拥塞控制(慢启动 → 拥塞避免 → 快重传 → 快恢复)
4.3 RTMP 简单原理(直播会用到)
RTMP 协议本质:基于 TCP 的流媒体协议,Adobe 设计。
推流流程:
plaintext
TCP 握手 → RTMP 握手 (C0/C1 → S0/S1/S2 → C2)
→ Connect (建立应用连接)
→ CreateStream (创建流)
→ Publish (声明推流)
→ 发送 FLV 音视频数据
FLV 封装:RTMP 传的不是裸 H.264,而是 FLV tag。H.264 NAL 需要从 Annex-B 格式(00 00 00 01 起始码)转成 AVCC 格式(4 字节长度前缀)。
为什么直播选 RTMP?
基于 TCP,丢包重传保证可靠性
延迟 1-3 秒,可接受
生态成熟,CDN 厂商普遍支持
RTMP 的缺点:
TCP 队头阻塞:一个包丢了,后续包都等着
延迟下限受 TCP 重传限制,做不到亚秒级
趋势是 SRT / WebRTC 替代 RTMP 实现超低延迟
面试加分话术:
"项目中用 RTMP 推流,编码后的 H.264 NAL 需要转成 AVCC 格式封装成 FLV tag。遇到过一个坑:MediaCodec 输出的第一个 buffer 是 SPS/PPS(codec config),必须单独提取并拼成 AVC Sequence Header 在推流开始时发送,否则播放端解码器初始化失败导致花屏。弱网下 RTMP 的 TCP 队头阻塞会导致延迟累积,我们的方案是检测发送队列堆积超过阈值时主动降码率,避免队列无限增长。"
五、数据库
5.1 SQLite 基础
Android 中的 SQLite:
SQLiteOpenHelper管理数据库创建和版本升级SQLiteDatabase提供增删改查 API推荐用 Room(Jetpack)封装,编译期检查 SQL,支持 LiveData/Flow
增删改查:
// insert
db.insert("table", nullColumnHack, contentValues);
// query
Cursor cursor = db.query("table", columns, selection, args, groupBy, having, orderBy);
// update
db.update("table", values, "whereClause", args);
// delete
db.delete("table", "whereClause", args);
5.2 事务
db.beginTransaction();
try {
    // 批量操作
    db.insert(...);
    db.insert(...);
    db.setTransactionSuccessful(); // 标记成功
} finally {
    db.endTransaction(); // 没标记成功就回滚
}
为什么要用事务?
原子性:要么全成功要么全回滚
性能:不用事务每条 SQL 都触发一次磁盘写入(fsync),1000 条插入从 30 秒降到 300ms
面试加分话术:
"直播间的弹幕消息需要本地缓存做历史记录查看。批量插入弹幕时用事务包裹,1000 条消息从 25 秒降到 200ms,因为不用事务每条 insert 都会触发 fsync 刷盘,事务模式下只在 endTransaction 时刷一次。"
5.3 大数据量优化
Room 的优势(面试加分):
编译期检查 SQL 语法
自动映射 Java/Kotlin 对象
支持 RxJava/Coroutines/Flow
自动处理迁移(Migration)
kotlin
@Dao
interface DanmuDao {
    @Query("SELECT * FROM danmu WHERE roomId = :roomId ORDER BY time DESC LIMIT :limit OFFSET :offset")
    suspend fun getDanmuList(roomId: String, limit: Int, offset: Int): List<Danmu>

    @Insert
    suspend fun insertBatch(danmus: List<Danmu>)

    @Transaction  // Room 自动用事务包裹
    suspend fun insertAll(danmus: List<Danmu>) {
        danmus.forEach { insert(it) }
    }
}
六、性能 & 内存优化
6.1 LeakCanary 与内存泄漏
LeakCanary 检测原理:
ObjectWatcher.watch()对目标对象创建KeyedWeakReference(弱引用 + ReferenceQueue)GC 回收弱引用对象时,弱引用会被放入 ReferenceQueue
如果一段时间后(默认 5 秒 + 两次 GC)弱引用没出现在 Queue 中 → 疑似泄漏
dumpHeap()生成 hprof 文件用 Shark(C++ 实现的 hprof 解析器,替代 HAHA)分析引用链
找到 GC Root 到泄漏对象的最短路径,展示给开发者
常见泄漏场景:
面试加分话术:
"直播项目中 LeakCanary 报过一个泄漏:Activity 持有推流编码器的回调对象,编码器在子线程异步运行,Activity 销毁时编码器还没结束,导致 Activity 无法回收。修复方案是将回调改为弱引用,并在 Activity onDestroy 时主动调
encoder.release()停止编码线程。还有一个泄漏是礼物动画的 AnimatorListener 没移除,在 onDestroy 里animator.cancel()+animator.removeAllListeners()解决。"
6.2 OOM
常见 OOM 场景:
Bitmap 过大:1080×1920 ARGB_8888 = 1080×1920×4 = 8.3MB,加载多张就 OOM
内存泄漏累积:多次进出页面,泄漏叠加到堆耗尽
帧缓存无上限:直播预览帧缓冲队列不限制大小
大文件一次读入内存:JSON/视频文件全量加载
Bitmap 优化:
// 采样率加载
BitmapFactory.Options opts = new BitmapFactory.Options();
opts.inJustDecodeBounds = true;  // 先只量尺寸
BitmapFactory.decodeFile(path, opts);
// 计算采样率
opts.inSampleSize = calculateSampleSize(opts, targetW, targetH);
opts.inJustDecodeBounds = false;  // 真正加载
Bitmap bmp = BitmapFactory.decodeFile(path, opts);

// Bitmap 配置优化
opts.inPreferredConfig = Bitmap.Config.RGB_565;  // 2字节/像素,省50%内存
// (但不支持透明通道,适合照片不适合UI图标)

// Android 8.0+ Bitmap 直接在 native 层分配,不会计入 Java 堆
onTrimMemory 回调:
@Override
public void onTrimMemory(int level) {
    if (level >= TRIM_MEMORY_BACKGROUND) {
        // 后台时清空图片缓存
        Glide.get(this).clearMemory();
    }
}
面试加分话术:
"直播间的观众头像列表是 OOM 重灾区,几百个头像 Bitmap 同时在内存中。用 Glide 做图片加载,配置
diskCacheStrategy(ALL)+ 内存缓存限制。直播间退出时在 onTrimMemory 回调里清空 Glide 内存缓存。另外推流 SDK 的预览帧缓冲队列最初无上限,弱网时堆积几百帧 YUV(每帧 3MB),直接 OOM。后来加了队列上限 5 帧,超出时丢弃最旧帧。"
6.3 卡顿检测
三种检测手段:
1. Choreographer.FrameCallback
Choreographer.getInstance().postFrameCallback(new Choreographer.FrameCallback() {
    long lastTime = 0;
    @Override
    public void doFrame(long frameTimeNanos) {
        if (lastTime > 0) {
            long diff = (frameTimeNanos - lastTime) / 1_000_000; // ms
            if (diff > 16) {  // 超过一帧
                int dropped = (int) (diff / 16) - 1;
                Log.w("Jank", "掉帧 " + dropped + " 帧, 耗时 " + diff + "ms");
            }
        }
        lastTime = frameTimeNanos;
        Choreographer.getInstance().postFrameCallback(this);
    }
});
2. BlockCanary(原理):替换 Looper 的 mLogging(Printer),在 dispatchMessage 前后打印时间差,超过阈值认为卡顿。缺点是 Printer 本身有性能开销。
3. SysTrace / Perfetto:在关键方法插桩 Trace.beginSection() / Trace.endSection(),抓 trace 看每帧耗时分布。
面试加分话术:
"直播项目中用 Choreographer.FrameCallback 做线上卡顿监控,发现掉帧严重时自动上报堆栈。有一次发现礼物连击 View 的 onDraw 里每次都 new Paint 对象,60fps 下每秒创建 60 个 Paint,导致频繁 GC。改为成员变量复用后掉帧率从 12% 降到 1%。还遇到过一次是弹幕 RecyclerView 的 ViewHolder 复用失效,因为 itemViewType 写错了,每个 item 都新建 ViewHolder,布局 inflation 大量卡顿。"
6.4 启动优化
冷启动流程:
用户点击图标 → Zygote fork 进程 → ActivityThread.main()
→ Application.onCreate() → Activity.onCreate() → 首帧绘制
优化手段:
异步初始化框架思路:
// 把初始化任务按依赖关系拓扑排序,有依赖的串行,无依赖的并行
// 核心链路: 推流SDK → 美颜SDK → IM SDK (串行)
// 非核心: 统计SDK、推送SDK、日志SDK (并行,子线程)
面试加分话术:
"直播 App 冷启动从 3.2 秒优化到 1.5 秒。分析 SysTrace 发现 Application.onCreate 耗时 1.8 秒,里面有 8 个 SDK 串行初始化。改造方案:核心链路(推流 SDK + IM SDK)在主线程串行初始化,非核心(统计、推送、日志、热更新)全部放到子线程并行初始化。同时首屏直播间用 ViewStub 延迟加载互动区,先让视频画面快速展示。推流 SDK 的 so 库加载用
System.loadLibrary放到异步线程,首次推流时用 CountDownLatch 确保已加载完毕。"
6.5 UI 掉帧
掉帧根因:每帧 16ms(60fps)内没完成 measure + layout + draw。
常见原因和优化:
过度绘制检测:开发者选项 → 调试 GPU 过度绘制。颜色含义:
蓝色:多绘制 1 次(可接受)
绿色:2 次(可接受)
浅红:3 次(需优化)
深红:4+ 次(必须优化)
面试加分话术:
"直播间互动区域掉帧严重,用 GPU 呈现模式分析发现大量深红区域。根因是弹幕层、礼物层、点赞层三个 FrameLayout 叠加,每层都有不透明背景。优化方案:中间层背景改为
@null,只在最底层保留背景;弹幕列表用setHasFixedSize(true)避免 RecyclerView 每次都 requestLayout;礼物特效的 SurfaceView 改为独立 Window 层(WindowManager.addView),避免影响 View 树的绘制。优化后从每帧 32ms 降到 12ms,掉帧率从 15% 降到 2%。"
面试回答建议
自我介绍时突出三个关键词:Android 音视频、直播推流、性能优化。
被问到自定义 View 时:引到直播间礼物连击 View 的实现,讲 measure + 事件分发 + 滑动冲突处理。
被问到多线程时:引到推流 pipeline 的线程模型——采集线程、编码线程池、网络发送线程,用 Handler 做跨线程通信。
被问到性能优化时:用"Profile 驱动"的思路串联——先用 Choreographer/SysTrace 量化问题,再针对性优化,最后用数据验证效果。强调每个优化都有前后对比数据,这是面试官最看重的。
被问到网络协议时:结合 RTMP 推流讲 TCP 的实际应用,展示你不只是背概念而是理解了协议在项目中的作用。
以上覆盖了六大模块的全部面试要点,每个知识点都配了直播项目实战案例和面试话术。三张图分别帮你建立了 View 绘制+事件分发、Handler 消息机制+ANR、性能优化工具链的视觉记忆框架。
核心面试策略:每个技术点都落到"我在直播项目中怎么用的、遇到什么问题、怎么解决的、效果数据是多少",用数据和案例说话,面试官会觉得你是真正做过而不是背过。